วันจันทร์ที่ 9 มิถุนายน พ.ศ. 2557

มาเล่น OPEN edX กัน

edX เป็นคอร์สเรียนออนไลน์จากมหาวิทยาลัยชั้นนำต่างๆ ที่เปิดโอกาสให้ผู้เรียนนอกจากคอร์สปกติได้มีโอกาสเรียนผ่านระบบอินเตอร์เน็ต ซึ่งปัจจุบันมีมหาวิทยาลัยชั้นนำอย่าง MIT, Stanford, Harvard หรือแม้กระทั่ง Linux Foundation ก็เปิดหลักสูตร Intro to Linux บน edX เช่นกัน นอกจากการให้บริการคอร์สเรียนออนไลน์แล้ว edX ยังเปิดโค้ดของระบบหลังบ้านทั้งหมดเป็นโอเพนซอร์สโดยใช้สัญญาอนุญาติแบบ AGPL ภายใต้โครงการ OPEN edX โครงการนี้มีมหาวิทยาลัยหลายแห่งร่วมกันพัฒนานา เช่น Stanford University, MIT, The University of Queensland, Tsinghua University, UC Berkeley Harvard University และ Google ทำให้โครงการ OPEN edX มีการพัฒนาอย่างต่อเนื่อง


สำหรับผู้ที่สนใจ OPEN edX สามารถทดลองใช้งานกันได้ผ่าน


หรือติดตั้งแบบ


อันนี้แล้วแต่เลือกครับ ใครมี AWS ก็ใช้ Cloud Formation Template ช่วยได้ แต่คนที่ไม่ทีแล้วอยากติดตั้งเล่นเอง ไม่อยากเล่นผ่าน vagrant ก็สามารถติดตั้งเองได้ครับ


เตรียมเครื่องเซิร์ฟเวอร์ที่มีคุณสมบัติดังนี้


  • CPU 4 Cores ขึ้นไป

  • Memory 4GB ขึ้นไป

  • HDD 50GB ขึ้นไป

  • เชื่อมต่อ internet

  • ติดตั้ง Ubuntu 12.04.4 LTS 64 Bits Server


ผมไม่มีเครื่องเซิร์ฟเวอร์แบบนี้ ก็เลยอาศัยบริการของ Microsoft Azure โดยใช้เครื่องแบบ Standard ขนาด A4 ครับ สำหรับท่านที่เงินไม่พอก็ใช้ขนาด Standard A3 ก็ได้ครับ :) มาลงมือกันเลย


เริ่มจากอัพเดท package และอัพเกรดระบบกันก่อน


sudo apt-get update -y


sudo apt-get upgrade -y


sudo reboot


จากนั้นติดตั้ง package ที่ต้องใช้งานกัน อ้อเกือบลืมไป เราจะใช้ ansible เป็นระบบ configuration นะครับ ที่ต้องใช้ ansible เพราะ OPEN edX บังคับใช้ครับ T_T


sudo apt-get install -y build-essential software-properties-common python-software-properties curl git-core libxml2-dev libxslt1-dev python-pip python-apt python-dev


อัพเดท pip และ virtualenv ก่อน


sudo pip install --upgrade pip


sudo pip install --upgrade virtualenv


จากนั้น clone configuration script (playbook) จาก github มา


cd /var/tmp


git clone -b release https://github.com/edx/configuration


ติดตั้ง dependency package ที่ต้องใช้เพิ่มเติม


cd /var/tmp/configuration


sudo pip install -r requirements.txt


จากนั้นเข้าไปที่ playbooks ที่เราต้องใช้ แล้วสั่งติดตั้งได้เลย


cd /var/tmp/configuration/playbooks


sudo ansible-playbook -c local ./edx_sandbox.yml -i "localhost,"


นั่งรอประมาณ 2 ชั่วโมงครับ ถ้าไม่มี error แดงๆ แล้วหลุดมาที่ shell เป็นอันใช้ได้ ที่บอกอย่างนี้เพราะ playbook script ทำออกมาได้เห่ยมากครับ :P


เอาล่ะ ระหว่างนี้เกิดอะไรขึ้นบ้าง playbook จะติดตั้ง OPEN edX Platform ลงไปที่ /edx ติดตั้ง python modules, ruby, supervisord, mongodb, openjdk และอื่นๆ เรื่องที่ต้องทราบก่อนจะเข้าไปเล่นในระบบ


ansible แก้ไขไฟล์ระบบบางส่วนด้วย ตาม rules ใน playbooks ระหว่างนี้ห้ามออกจาก ssh เพราะว่า ansible แก้ไข sshd_config ด้วย เพื่อจัดการเรื่อง security ซึ่งมีผลทำให้คุณจะต้องใช้ ssh key ในการ remote เข้ามา ให้ติดตั้ง public key ให้เรียบร้อย ก่อน log out ไม่ใช่นั้นคุณจะ ssh เข้าระบบไม่ได้ ;)


ระบบติดตั้ง sample user มา 4 คน คือ


  • audit@example.com รหัสผ่าน edx

  • honor@example.com รหัสผ่าน edx

  • staff@example.com รหัสผ่าน edx

  • verified@example.com รหัสผ่าน edx


แต่ไม่มี admin ของระบบ อันนี้คงเป็นเรื่องความปลอดภัยเช่นกัน (เดานะ) การเปลี่ยน role ต้องทำผ่าน edX command line เท่านั้น หรือผ่านหน้า admin ของ Djungo วิธีการสร้าง superuser ดูได้ที่หน้า Wiki ครับ


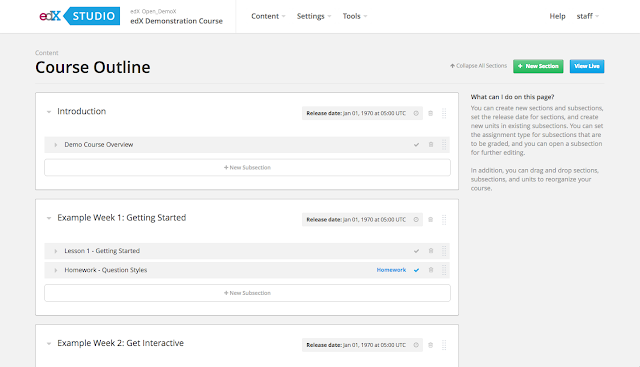
OPEN edX Platform จะมีระบบ 2 ส่วนใหญ่ๆ คือ


  • LMS - http://your-edx-server.com

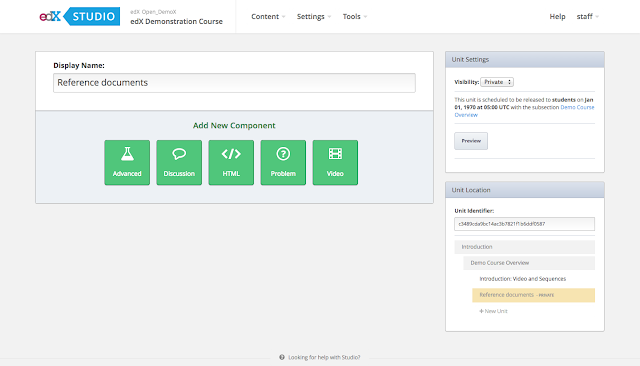
  • Studio - http://your-edx-server.com:18010


LMS คือส่วนของห้องเรียน และ Studio คือเครื่องมือสร้างบทเรียน เวลาเข้าใช้งานก็เข้าให้ถูก port นะครับ มาดูหน้าจอกันว่ามีอะไรบ้าง









วันอาทิตย์ที่ 8 มิถุนายน พ.ศ. 2557

Drupal Blocking tool

ในบรรดาปัญหาต่างๆ สำหรับ Drupal ที่ผู้ดูแลเว็บไซต์ต้องเจอ ปัญหาอันดับต้นๆ ที่ทุกคนต้องปวดหัวคงหนีไม่พ้นเรื่องของการจัดการสแปม วันนี้ก็เลยจะมาแนะนำเครื่องมือที่น่าจะเอามาลองพิจารณาดูครับ


  1. Policy ครับ นโยบาย อันนี้ไม่มีเป็นโมดูลครับ ต้องจัดการเอง เริ่มจากกำหนดให้ดีว่าใครจะสามารถใส่เนื้อหาลงในเว็บได้บ้าง (ทุกคน หรือเฉพาะสมาชิก) ถ้าเปิดให้สมาชิกโพสได้ แล้วใครสมัครสมาชิกได้บ้าง การอนุมัติการเป็นสมาชิกจะทำด้วยวิธีไหน อันนี้สำคัญมาก

  2. reCAPTCHA เป็นตัวช่วยในการชืนยันความเป็นมุษย์ของผู้เข้าใช้งานเว็บ โดยจะแสดงข้อความยึกยือขึ้นมาให้เราพิมพ์ตาม ว่าเราอ่านรู้เรื่องหรือไม่

  3. http::BL HTTP Black List ตัวนี้จะคอย Block IP ของสแปมเมอร์ให้ครับ เป็นตัวที่ควรมีไว้

  4. Bad Behavior จะคอยตรวจสอบพฤติกรรมการเข้าใช้งานเว็ย ว่าเป็นคนหรือเป็นหุ่นโดยการวิเคราะห์จาก HTTP

  5. Mollom เป็นตัวที่หลายคนแนะนำ แต่หลังๆ ทำงานไม่ค่อยดี ผมเลยถอดไปแล้ว (ไม่แน่ใจว่าถ้าใช้แบบเสียเงินจะดีไหม) ตัวโปรแกรมจะมีบริการสำหรับวิเคราห์สแปม แล้วก็สั่งบล๊อกให้อัตโนมัติครับ


ส่วนตัวก็ยังไม่เจอโซลูชั่นที่สมบูรณ์แบบครับ เพราะสแปมเมอร์ก็ฉลาดมาก ยังต้องคอยไล่ลบด้วยมือเป็นระยะๆ ยังไงแล้วถ้าได้เทคนิควิธีการที่ดีกว่านี้จะนำมาฝากครับ


วันพุธที่ 4 มิถุนายน พ.ศ. 2557

ตั้งค่าเครื่องมือเสริชใน Chrome

ผมเองเป็นคนที่ใช้ Chrome browser มาหลายปีมาก จนล่าสุดหลังจากขยับมาใช้ Ubuntu 14.04 ก็เลยพยายามจะลองใช้ Firefox ดู เพราะชอบเครื่องมือ Webdeveloper ของ Firefox มากกว่า แต่ใช้ได้ไม่กี่วันก็ต้องกลับมาตายรังที่ Chrome อีกอยู่ดี แล้วปล่อยให้มันสูบพลังของ CPU ต่อไป


เหตุที่ใช้ Firefox ไม่รอดเพราะติดที่ความสามารถบางอย่างของ Firefox นั้นไม่ตอบสนองต่อความต้องการครับ วันนี้ก็เลยจะมาแนะนำความสามารถอย่างหนึ่งของ Chrome กัน คือ การจัดการตัวเสริช


โดยปกติเวลาเราจะเสริชอะไรใน Browser เราก็จะพิมพ์คำค้นลงไปใน Address bar เลย แล้ว Browser จะโดดเข้าไปที่หน้า Google search ให้เอง แต่นั่นยังไม่เป็นที่พอใจครับ มันช้าไป เลยต้องมาปรับแต่งหน่อย


สิ่งที่จะทำคือ ตั้งค่าให้เวลาที่เราพิมพ์คำค้นแล้วกด Enter ตัวโปรแกรมจะดึงผลลัพธ์ขึ้นมาให้เลย โดยอาศัยตัวเสริชของ Google ที่ชื่อว่า I'm feeling lucky


วิธีตั้งค่า ไปที่หน้าตั้งค่าของ Chrome ที่ส่วนของ "เครื่องมือค้นหา" ให้คลิกที่ "จัดการเครื่องมือค้นหา"


Imgur


เราจะพบส่วนจัดการเครื่องมือค้นหา


Imgur


เพิ่มค่าของ I'm feeing lucky ลงไป แล้วใส่ค่าตามบรรทัดข้างล่างลงในช่องดังภาพ


http://www.google.com/search?hl=en&q=%s&btnI=I%27m+Feeling+Lucky&aq=f&oq=


เพียงเท่านี้ในครั้งต่อไปที่เสริชก็จะได้ผลการค้นหาในทันทีแล้ว ไม่ต้องเข้าไปหน้า Google อีกต่อไป


นอกจากนี้เรายังสามารถเพิ่มตัวค้นหาอื่นๆ ได้อีกด้วย โดยกำหนดคีย์เวิร์ดลงไป แล้วก็ใส่ค่าลงไปตามนี้


  • google translate: http://translate.google.com/?source=osdd#auto|auto|%s

  • youtube: http://www.youtube.com/results?search_query=%s&page={startPage?}&utm_source=opensearch

  • facebook: http://www.facebook.com/search/?src=os&q=%s


วิธีใช้งานเราก็พิมพ์คำหลักลงไปก่อน ตามด้วยสเปซบาร์ และคีย์เวิร์ดที่ต้องการ


วันจันทร์ที่ 2 มิถุนายน พ.ศ. 2557

มาเล่น Logstash, ElasticSearch และ Kibana กัน

เนื่องจากมีผู้รู้แนะนำให้ลองเล่น Logstash. ElasticSearch และ Kibana เมื่อช่วงปลายปี 2013 มาวันนี้เพิ่งจะได้มาล่องเล่นดู เรื่องการจัดการ log ไฟล์ หลายคนอาจเคยได้ยิน syslog-ng หรืออะไรนองนั้น ซึ่งการเก็บ log ส่วนใหญ่เก็บลงไฟล์ เก็บไว้อย่างนั้นไม่ได้เอามาใช้ประโยชน์อะไร มันก็น่าเสียดาย เพราะ log เหล่านี้สามารถนำมาวิเคราะห์แบบ real time ได้ หากพบปัญหาที่ตรวจพบได้จาก log ก็สามารถแก้ไขได้ทันท่วงที Logstash และ ElasticSearh ต้องใช้ Java ดังนั้นติดตั้ง Java กันก่อน


apt-get install openjdk-7-jdk


จากนั้นดาวน์โหลด logstash และติดตั้งลงในเครื่อง


curl -O https://download.elasticsearch.org/logstash/logstash/logstash-1.4.1.tar.gz


tar zxvf logstash-1.4.1.tar.gz


cd logstash-1.4.1


ทดสอบการทำงานดูสักหน่อย


bin/logstash -e 'input { stdin { } } output { stdout {} }'


คุณจะพบว่า logstash ให้คุณพิมพ์อะไรลงไปก็ได้ จากนั้นก็จะ return log ออกมาดังภาพ


ติดตั้ง elasticsearch เราจะเอา log ที่ได้ไปเก็บไว้ในนี้


curl -O https://download.elasticsearch.org/elasticsearch/elasticsearch/elasticsearch-1.1.1.tar.gz


tar zxvf elasticsearch-1.1.1.tar.gz


cd elasticsearch-1.1.1


./bin/elasticsearch


ทดสอบการทำงานดูสักหน่อย


bin/logstash -e 'input { stdin { } } output { elasticsearch { host => localhost } }'


logstash จะให้คุณพิมพ์อะไรสักอย่างลงไป จากนั้นให้คุณใช้ curl ลองดูใน ES ว่าเก็บข้อมูลจาก logstash จริงหรือไม่


curl 'http://localhost:9200/_search?pretty'


จะได้ผลลัพท์ดังนี้


ทีนี้มาลอง ส่ง log ของ Apache ไปเก็บไว้ใน ES กันบ้าง ให้เขียน config ไฟล์ ดังนี้


input {


file {


path => "/var/log/apache2/access.log"


start_position => beginning


}


}


filter {


if [path] =~ "access" {


mutate { replace => { "type" => "apache_access" } }


grok {


match => { "message" => "%{COMBINEDAPACHELOG}" }


}


}


date {


match => [ "timestamp" , "dd/MMM/yyyy:HH:mm:ss Z" ]


}


}


output {


elasticsearch {


host => localhost


}


stdout { codec => rubydebug }


}


จากนั้นใช้คำสั่ง


bin/logstash -f logstash-apache.conf


รอสักครู่ logstash จะอ่านไฟล์ log แล้วส่งข้อมูลไปยัง ES ให้เรื่อยๆ ครับ ข้อมูลที่เก็บใน ES จะเป็นข้อมูลแบบ json ถ้าต้องการ Query ก็สามารถ Query ผ่าน ES ได้ แต่เราจะมาใช้ เครื่องมืออีกตัวหนึ่งเพื่อให้ชีวิตง่ายขึ้น คือ Kibana


curl -O https://download.elasticsearch.org/kibana/kibana/kibana-3.1.0.tar.gz


tar zxvf kibana-3.1.0.tar.gz


cd kibana-3.1.0/


แก้ไขไฟล์ config.js กำหนด ES Server ให้ถูกต้อง จากนั้นคัดลอกไฟล์ไปยัง Document Root ของ Web Server ที่เราใช้งานอยู่ จากนั้นเปิดเบราเซอร์ขึ้นมา เราจะได้หน้าจอดังนี้


ถ้ายังคิดอะไรไม่ออก คลิกไปที่ Link ที่เขียนว่า Logstash Dashboard คุณจะได้หน้าจอ Dashboard สำเร็จรูปมา 1 หน้าจอ


จากนี้คุณก็สามารถปรับแต่ง Dashboard ตามใจคุณได้แล้ว


วันอาทิตย์ที่ 1 มิถุนายน พ.ศ. 2557

สัมผัสประสบการณ์ BigData กับ HortonWorks

เนื่องจากได้เรียนวิชา BigData มาระยะหนึ่งโดยใช้ MapReduce Function บน MongoDB และใช้งาน Hadoop ก็พบว่ากว่าจะได้ใช้งานต้องใช้เวลาในการติดตั้งพอสมควร และการใช้ Hadoop อย่างเดียว ชีวิตคุณจะพบกับความทรมานอย่างแสนสาหัส เอาเป็นว่าใช้เครื่องมือที่เป็น Ecosystem ของ Hadoop เข้ามาช่วยจะดีที่สุด สำหรับผู้ที่ต้องการเรียนรู้เบื้องต้นว่า BigData เป็นอย่างไร จะเล่นกับ Hadoop ได้อย่างไร ผมแนะนำเครื่องมือง่ายๆ ที่จะทำให้คุณเรียนรู้การใช้งาน Hadoop ได้อย่างรวดเร็ว คือ HortonWorks Sandbox ครับ HortonWorks Sandbox เป็นชุด Appliance ที่รวบรวมเอาเครื่องมือที่เกี่ยวข้องกับ Haddop มารวบรวมไว้พร้อมใช้งานเพื่อศึกษาการใช้งานและการทำงานร่วมกับ Hadoop สำหรับ Sandbox แบ่งเป็น VM Image สำหรับ VirtualBox, VMWare และ HyperV สามารถดาวน์โหลดเอาไปทดลองเล่นกันได้


ในชุดของ Sandbox ประกอบด้วย


  • Apache Hadoop

  • Apache Hive

  • Apache HBase

  • Apache Pig

  • Apache Storm

  • Apache Solr

  • Apache Falcon

  • Apache Sqoop

  • Apache Flume

  • Apache Oozie

  • Apache Ambari

  • Apache Mahout

  • Apache ZooKeeper

  • Apache Knox


เรียกได้ว่ามายกชุดกันเลยทีเดียว


มาลองเล่น MapReduce บน HortonWorks กันกับปัญหาพื้นฐานนับจำนวนคำ เราจะใช้หนังสือของคุณ James Joyce ชื่อ Ulysses กันครับ ให้ดาวน์โหลดมาแล้วแตกไฟล์ zip ให้เรียบร้อย แล้วใช้ File Browser เพื่อ upload ไฟล์หนังสือเข้าไป


จากนั้นใช้ Pig Script เขียน code ดังนี้


a = load '/user/hue/4300.txt';


b = foreach a generate flatten(TOKENIZE((chararray)$0)) as word;


c = group b by word;


d = foreach c generate COUNT(b), group;


store d into '/user/hue/pig_wordcount';


กำหนดชื่อ Script นี้ แล้วสั่ง Execute ครับ ผลลัพท์ที่ได้จะอยู่ในไดเรคทอรี /user/hue/pig_wordcount ผลลัพท์ที่ได้จะอยู่ในรูปแบบ key-value pair เรียกดูจาก File Manager ได้ครับ


จากนั้นเราก็เอาผลลัพท์ที่ได้ import เข้า HCatalog เพื่อสร้าง table เพื่อให้ใช้ SQL Query ได้ เพิ่มความสะดวกมากขึ้น จะได้ไม่ต้องเขียน script เรียกข้อมูลจาก key-value ให้ยุ่งยาก


ลองสั่ง Query ผ่าน Hive ดูครับ


เราก็จะได้ผลลัพท์ดังนี้


สำหรับ Word Count เป็นตัวอย่างง่ายๆ ของ MapReduce สำหรับท่านที่สนใจเรียนเพิ่มเติมก็สามารถดูรายละเอียดได้ที่หน้า Tutorial Gallery ครับ


วันจันทร์ที่ 26 พฤษภาคม พ.ศ. 2557

มาเล่น Zabbix กัน

Zabbix เป็น Monitoring System อีกตัวหนึ่งที่น่าสนใจ ซึ่งมีคุณสมบัติหลากหลาย ไม่ว่าจะเป็น Performance Monitoring, Availability Report, Trigger, Event และ Graphs เป็นต้น Zabbix มี Template เสริมหลายตัว สามารถติดตั้งเพิ่มเติมได้ง่าย แถมยังสามารถตั้ง Trigger เพื่อส่งการแจ้งเตือนผ่านทาง E-Mail, IM และ SMS ได้อีกด้วย ความสามารถเยอะขนาดนี้ มาลองเล่นกันดูครับ


ติดตั้งบน Ubuntu 12.04 ทำได้ง่ายมากเพราะ Zabbix มี Repository ให้บริการไว้แล้ว แค่ติดตั้ง repo package ดังนี้


wget http://repo.zabbix.com/zabbix/2.2/ubuntu/pool/main/z/zabbix-release/zabbix-release_2.2-1+precise_all.deb


dpkg -i zabbix-release_2.2-1+precise_all.deb


apt-get update


ติดตั้ง Zabbix Server


apt-get install zabbix-server-mysql zabbix-frontend-php


แก้ date.timezone ใน /etc/apache2/conf.d/zabbix จากนั้น restart apache ดังนี้


service apache2 restart


ติด Zabbix Agent ในเครื่องที่ต้องการ Monitor


apt-get install zabbix-agent


ตั้งค่า Zabbix Server ให้ Agent โดยใช้คำสั่ง


dpkg-reconfigure zabbix-agent


ใส่ hostname หรือ ip address ของเครื่อง Zabbix Server ให้ถูกต้อง


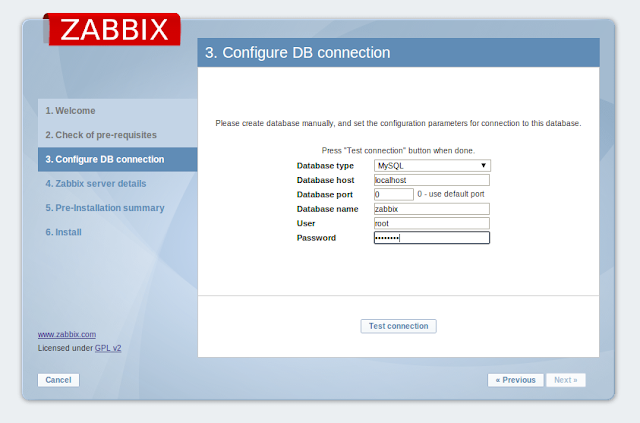
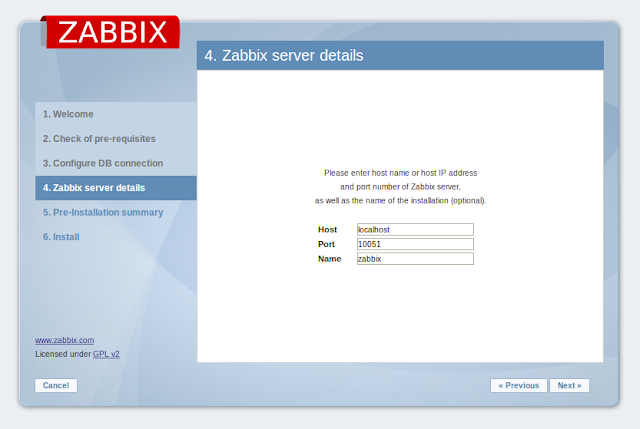
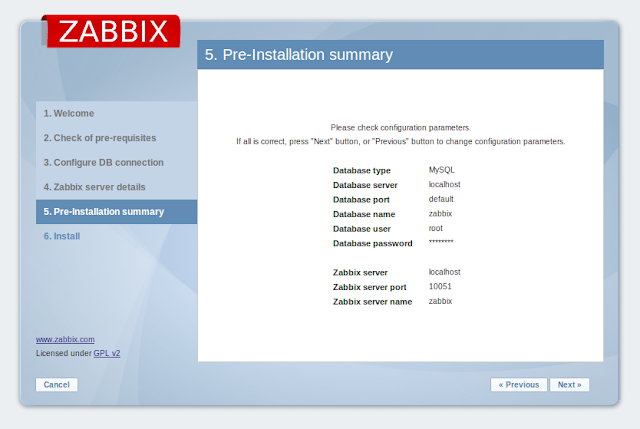
เปิด browser ไปที่ http://YOUR-ZABBIX-SERVER/zabbix ตั้งค่าอีกนิดหน่อย


จากนั้นจะเข้าสู่หน้าจอ Login กรอก username = Admin และ password = zabbix


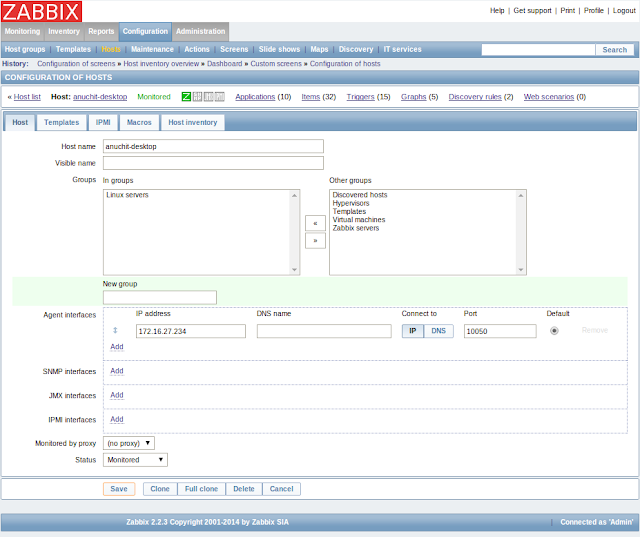
ก็จะเข้าหน้าหลักของ Zabbix แล้ว วิธีการใช้งานให้ติดตั้ง Zabbix Agent ไว้ที่เครื่องที่ต้องการ Monitor จากนั้น เพิ่ม Host ที่ Configuration > Hosts เลือก Create Host ใส่ข้อมูล Host ที่ต้องการ Monitor ลงไป


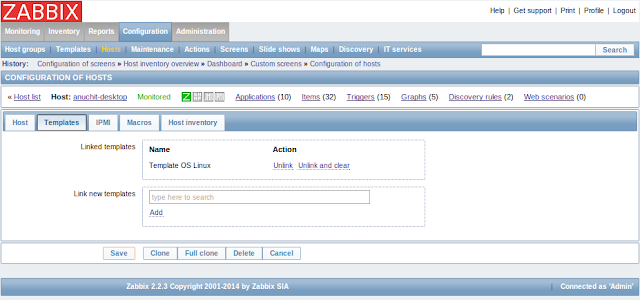
คลิกที่ Template เลือก Template ที่ต้องการ ตัวอย่างเช่น OS Linux ถ้าต้องการ Monitor Service เช่น HTTP, HTTPS, SMTP, SSH ก็สามารถเพิ่มเข้าไปได้


กด Save แล้ว เข้าไปดูที่ Monitoring > Lastest Data ว่ามีข้อมูลมาจาก Agent แล้วหรือยัง


เมื่อมีข้อมูลมาแล้วคุณสามารถดูข้อมูล System Status ผ่านหน้า Dashboard ได้ หรือจะดู Trigger หรือ Event ได้เช่นกัน


วันอาทิตย์ที่ 25 พฤษภาคม พ.ศ. 2557

มาเล่น Cacti กัน

เนื่องจากจำไม่ได้ว่าเคยเขียน How to เรื่อง Cacti ไปหรือยังและพยายามค้นดูแล้วหาไม่เจอ ก็เลยเอามาเขียนใหม่อีกรอบครับ Cacti เป็น Performance Monitoring System ตัวหนึ่งที่ใช้งานง่าย เน้นการจับข้อมูลจาก SNMP เป็นหลัก ทำให้การตั้งค่าการใช้งาน Cacti ง่ายตามไปด้วย อีกอย่างมี Plugin เสริมน่าที่สนใจหลายตัว มาลงมือกันเลย


apt-get update


apt-get install snmpd cacti cacti-spine


ตัวติดตั้งเริ่มให้คุณตั้งค่ารหัสผ่านให้กับ MySQL และ Config Cacti :) ง่ายป่าว จากนั้นเรามา config เจ้า SNMP เพิ่มอีกนิดหน่อย แก้ไขที่ไฟล์ /etc/snmp/snmpd.conf แก้ให้ snmpd listen connection on all interfaces


#agentAddress udp:127.0.0.1:161


agentAddress udp:161,udp6:[::1]:161


แก้ไข ACCESS CONTROL uncomment ตรง rocommunity แก้ ip address ให้เป็น ip address ของ Cacti


rocommunity secret Cacti-IP-Address


แก้ไขข้อมูล SYSTEM INFORMATION ให้สื่อความให้สักหน่อย


sysLocation Some Sererver


sysContact some@example.org


จากนั้น restart service ของ snmpd ดังนี้


service snmpd restart


จากนั้นมาตั้งค่า Cacti กัน เปิด browser ไปที่ http://your-cacti-server/cacti ล็อกอินด้วยผู้ใช้ admin รหัสผ่าน admin


จากนั้นโปรแกรมจะให้ตั้งรหัสผ่านใหม่


เมื่อตั้งรหัสผ่านเสร็จก็จะเข้าหน้า Cacti โล่งๆ แบบนี้


เปิดหน้า setting ที่ Configuration > Settings ตั้งค่า SNMP Version เป็น 2 และ SNMP Community เป็น secret


คลิกไปที่ Tab Poller เลือก Poller Type เป็น spine กำหนด Poller Inteval เป็น Every Minute กด Save


เพิ่ม Host ของเราเข้าไป ไปที่ Management > Devices กด Add ใส่ข้อมูล ระบุชื่อ hostname หรือ ip address เลือก Template เป็น Local Linux Machine กด Save


เพิ่ม Template เพิ่มเติม Unix - Ping Latency, SNMP - Get Mounted Partitions, SNMP - Get Processor Information, SNMP - Interface Statistics กด Save


กด Create Graphs for this Host เลือกกราฟทั้งหมด กด Create


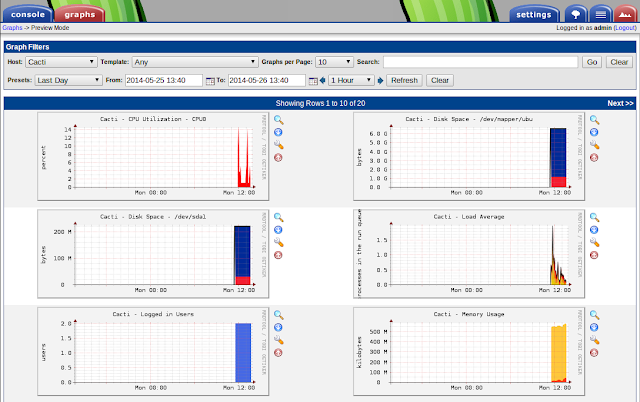
นั่งรอไปสักพัก เลือก Tab Graphs ก็จะพบกราฟที่ดึงมาจาก SNMP สวยงาม :)


ถ้าต้องการทำ report โดยเลือกเฉพาะบางกราฟ ให้ไปที่ Console > Management > Graph Trees เลือกสร้างรายงานที่คุณต้องการได้ ;)